
TRL documentation
TRL - تعلم التعزيز للحوّلات

TRL - تعلم التعزيز للحوّلات
TRL هي مكتبة متكاملة نقدم من خلالها مجموعة من الأدوات لتدريب نماذج اللغة التحويلية باستخدام طرق مثل الضبط الدقيق الإشرافي (SFT)، وتحسين السياسة النسبي الجماعي (GRPO)، وتحسين التفضيل المباشر (DPO)، ونمذجة المكافآت، وغيرها. تتكامل المكتبة مع 🤗 transformers.
🎉 ما الجديد
🔥 Mistral Large 4: قم بضبط Mistral Large 4 باستخدام SFTTrainer على عقدة واحدة مكوّنة من 8 وحدات B300، وذلك فوق أوزانها بصيغة FP8. راجع مثال LoRA.
🚀 التدريب على معالجات AMD الرسومية: تعمل مدرِّبات TRL الآن على AMD Instinct GPUs عبر إصدار ROCm من PyTorch.
🔥 Beam: اضبط Beam باستخدام SFTTrainer على عقدة واحدة تضم 8 من B300. راجع مثال LoRA.
🔥 Muse Spark Open: اضبط Muse Spark Open باستخدام SFTTrainer، مقسّمًا عبر وحدات معالجة الرسوميات لديك عند التحميل. راجع مثال LoRA على 8 عقد.
🚀 التدريب على AWS Trainium: تعمل مدرِّبات TRL الآن على AWS Trainium من خلال TorchNeuron، وهو واجهة Neuron الأصلية في PyTorch.
تصنيف
فيما يلي نظرة عامة على مدرّبي TRL، منظمة حسب درجة النضج ونوع الطريقة.
تجريبي
يمكنك أيضًا استكشاف النماذج ومجموعات البيانات والعروض التوضيحية المتعلقة بـ TRL في منظمة TRL على Hugging Face.
تعلّم
تعلّم ما بعد التدريب باستخدام TRL ومكتبات أخرى في 🤗 smol course.
المحتويات
تنظم التوثيقات في الأقسام التالية:
- البدء: دليل التثبيت والبدء السريع.
- أدلة مفاهيمية: صيغ مجموعات البيانات، الأسئلة الشائعة حول التدريب، وفهم السجلات.
- أدلة الاستخدام: تقليل استهلاك الذاكرة، تسريع التدريب، توزيع التدريب، وما إلى ذلك.
- التكاملات: DeepSpeed وPEFT وغيرها
- أمثلة: نظرة عامة على الأمثلة، شروحات المجتمع، وما إلى ذلك.
- واجهة برمجة التطبيقات: المدربين والأدوات المساعدة وما إلى ذلك.
منشورات المدونة
نُشر في 27 مايو 2026
شحن تريليون من المعلمات عبر حاوية Hub: مزامنة أوزاما الدلتا في TRL

نُشر في 31 مارس 2026
TRL v1: مكتبة ما بعد التدريب التي تثبت صلابتها عندما يُبطل المجال افتراضاته الخاصة
نُشر في 10 مارس 2026
دع الرموز تتدفق: دروس مستفادة من 16 مكتبة تعليل معزز مفتوحة المصدر
نُشر في 9 مارس 2026
توازي تسلسل أليسس: التدريب بسياقات بملايين الرموز
نُشر في 23 أكتوبر 2025
بناء منظومة الوكلاء المفتوحة معاً: تقديم OpenEnv
نُشر في 7 أغسطس 2025
محاذاة نماذج اللغة البصرية في TRL ⚡️
نُشر في 3 يونيو 2025
لا يُترك أي GPU خلفاً: تحرير الكفاءة باستخدام vLLM المتزامن في TRL
نُشر في 25 مايو 2025
🐯 لقاء Liger GRPO مع TRL
نُشر في 28 يناير 2025
Open-R1: إعادة إنتاج مفتوحة بالكامل لـ DeepSeek-R1
نُشر في 10 يوليو 2024
تحسين التفضيلات لنماذج الرؤية واللغة باستخدام TRL
نُشر في 12 يونيو 2024
إعادة تعزيز التعلم إلى تعزيز التعلم بالتغذية الراجعة البشرية
نُشر في 10 يناير 2024
اجعل ضبط نماذج اللغة الكبيرة (LLM) أسرع مرتين باستخدام Unsloth و🤗 TRL
نُشر في 29 سبتمبر 2023
ضبط نماذج Stable Diffusion بدقة باستخدام DDPO عبر TRL
نُشر في 8 أغسطس 2023
ضبط Llama 2 بدقة باستخدام DPO
نُشر في 5 أبريل 2023
StackLLaMA: دليل عملي لتدريب LLaMA باستخدام RLHF
نُشر في 9 مارس 2023
ضبط نماذج اللغة الكبيرة (LLMs) ذات 20 مليار معامل باستخدام RLHF على بطاقة رسومات استهلاكية بسعة 24 جيجابايت
نُشر في 9 ديسمبر 2022
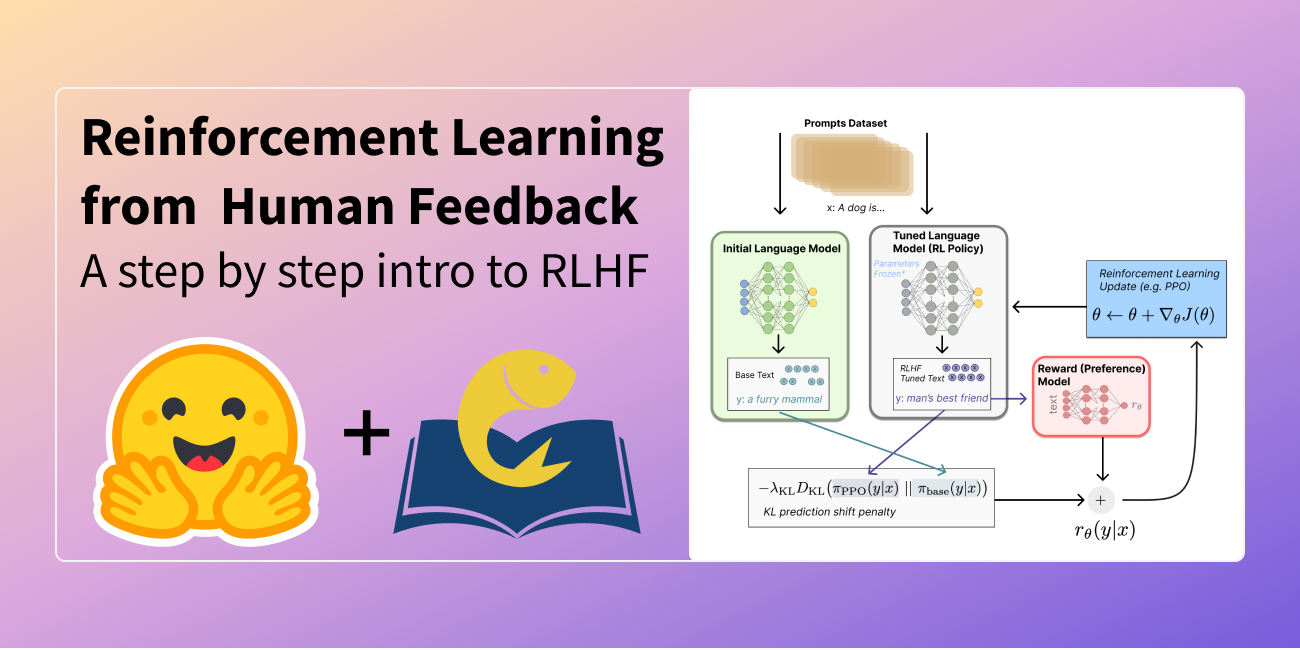
توضيح التعلم المعزز من تغذية راجعة بشرية
