
LeRobot documentation
LIBERO
LIBERO
The commands below run the simulator locally. To keep its dependencies away from your policy's, serve it instead with `lerobot-env-server --config_path=docker/sim/configs/libero.yaml --sim.task=--docker=true`, where ` ` is the command's `--env.task`, and add `--env.server.endpoint=tcp/127.0.0.1:7448` to the command. A server runs the task it was started with (see [Simulation: local or served](./simulation)).
LIBERO là một benchmark được thiết kế để nghiên cứu học suốt đời cho robot — ý tưởng rằng robot cần tiếp tục học và thích ứng cùng người dùng theo thời gian, chứ không chỉ được huấn luyện trước một lần. Nó cung cấp một bộ các thao tác chuẩn hóa tập trung vào chuyển giao kiến thức: mức độ robot có thể áp dụng những gì đã học vào các tình huống mới. Bằng cách đánh giá trên LIBERO, các thuật toán khác nhau có thể được so sánh một cách công bằng và các nhà nghiên cứu có thể xây dựng dựa trên công việc của nhau.
- Bài báo: Benchmarking Knowledge Transfer for Lifelong Robot Learning
- GitHub: Lifelong-Robot-Learning/LIBERO
- Trang web dự án: libero-project.github.io
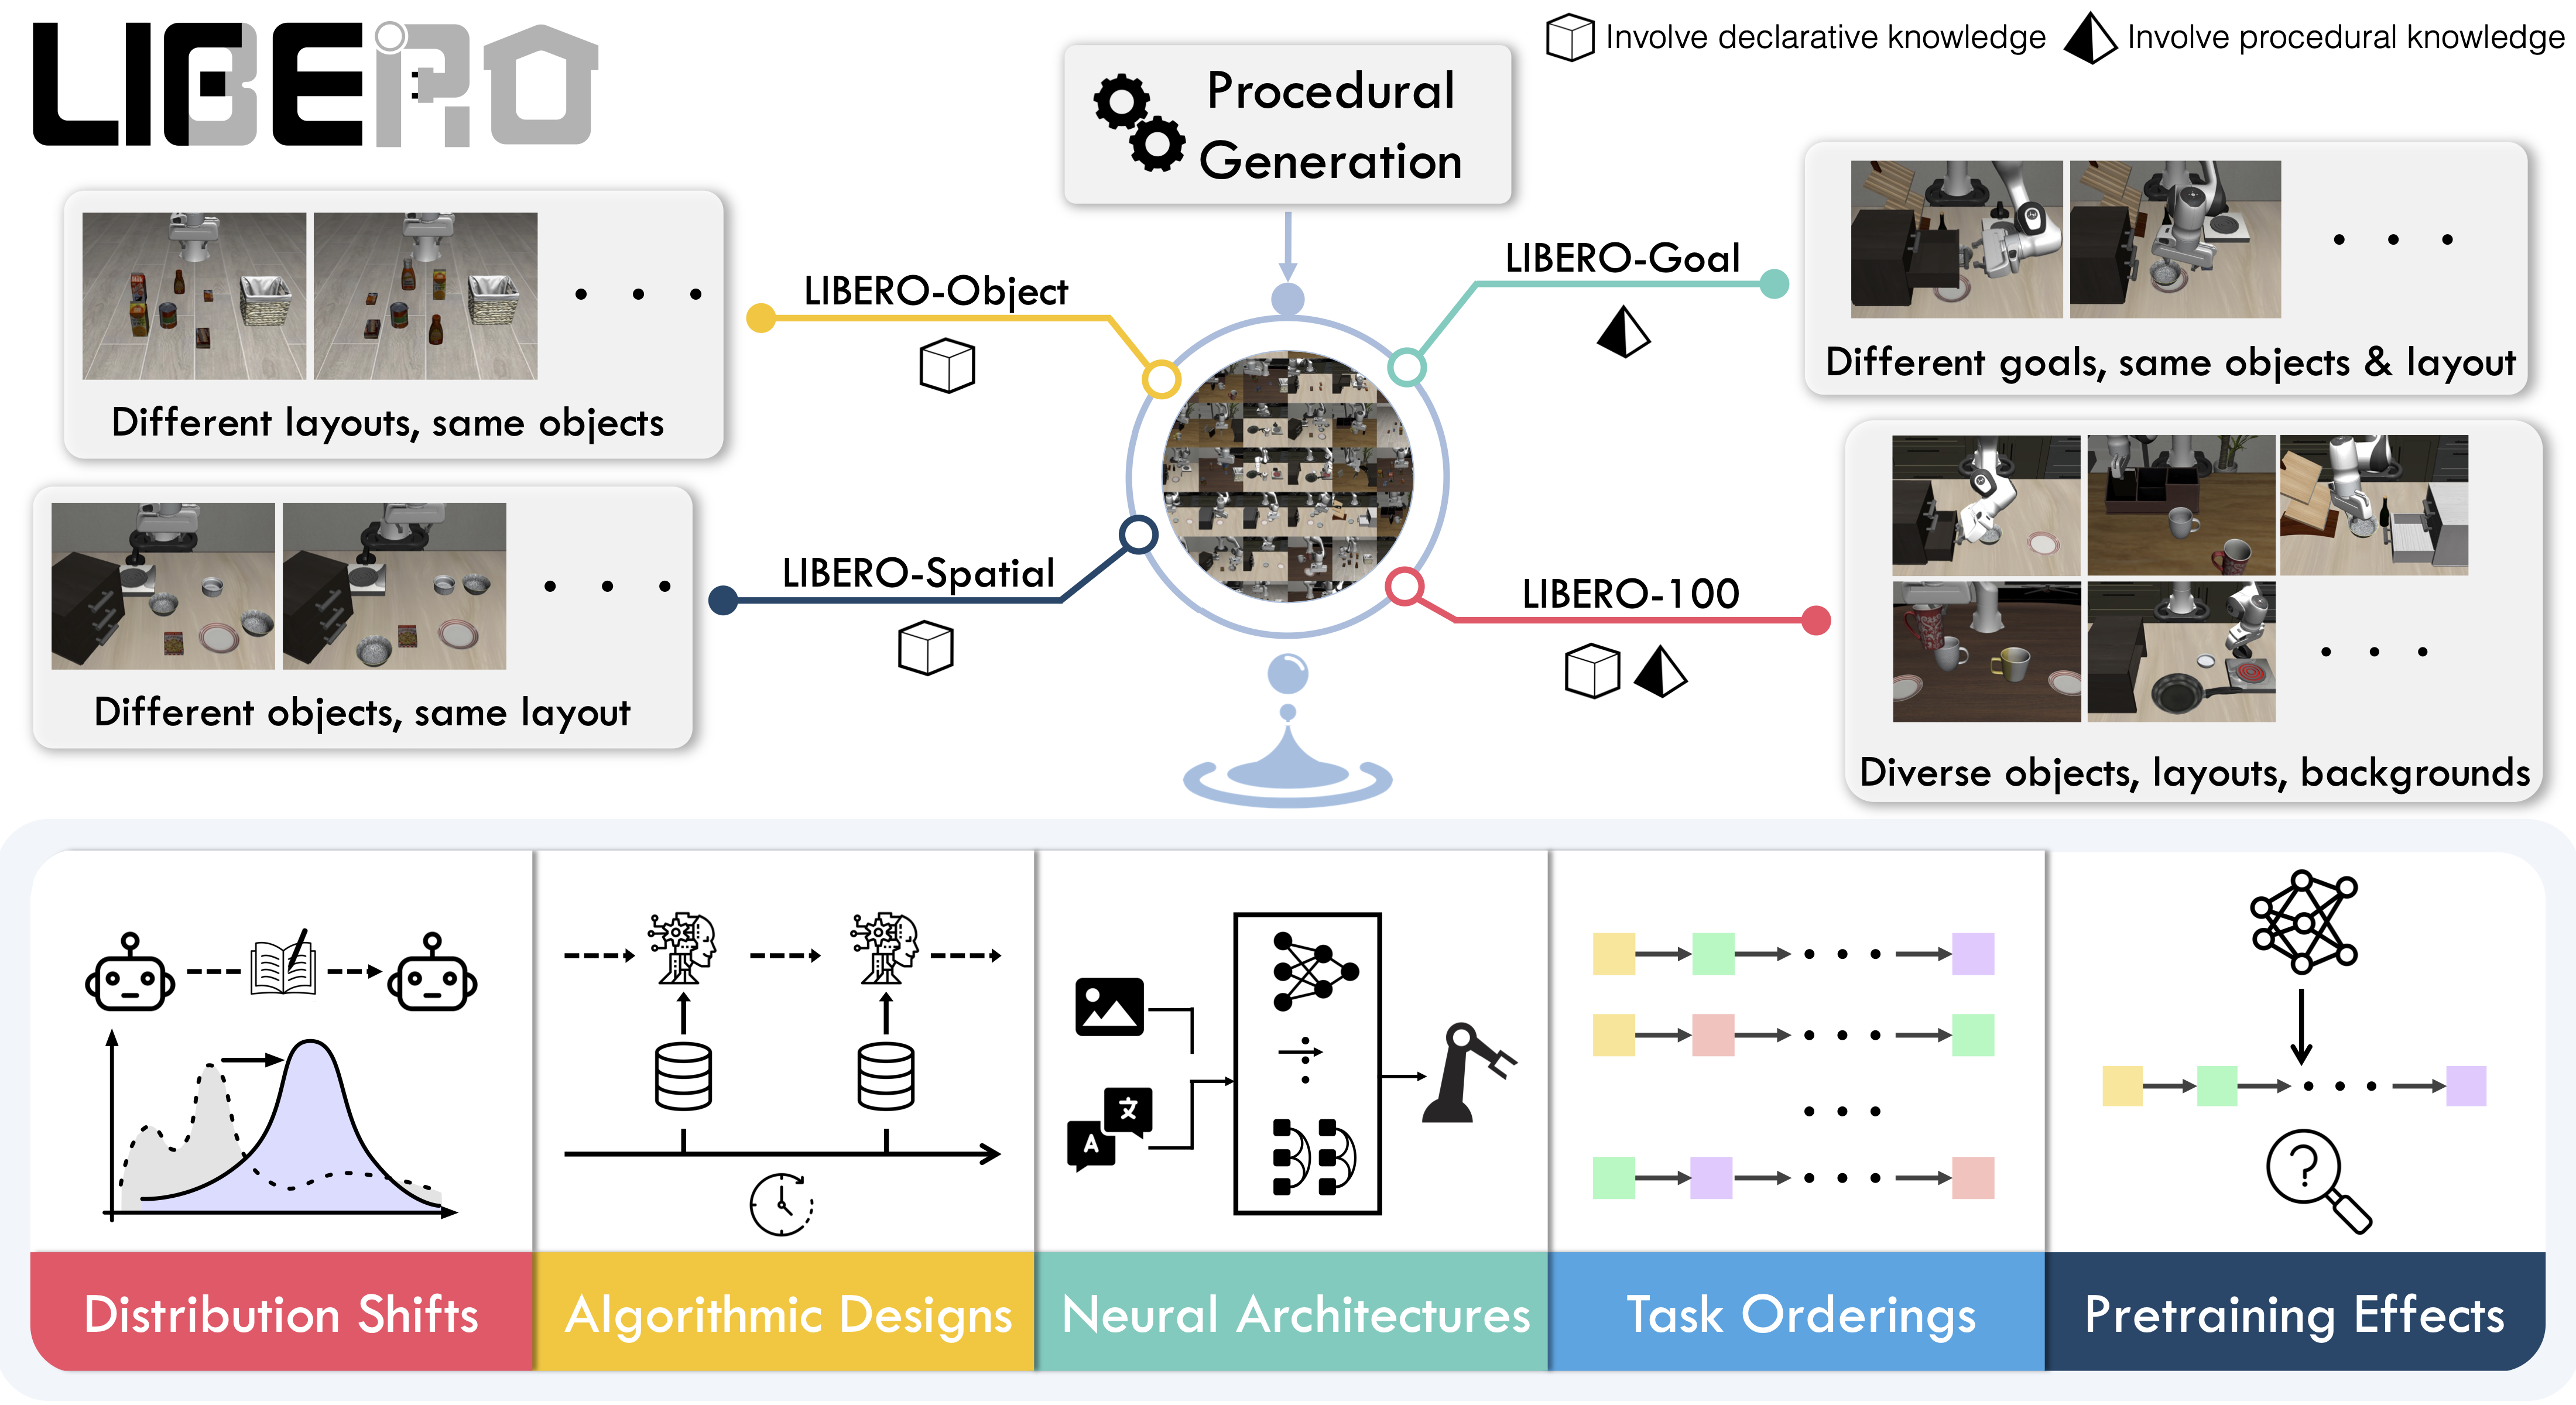
Các tác vụ khả dụng
LIBERO bao gồm năm bộ nhiệm vụ bao phủ 130 nhiệm vụ, trải dài từ các thao tác đối tượng đơn giản đến các kịch bản nhiều bước phức tạp:
| Bộ | Tên CLI | Nhiệm vụ | Mô tả |
|---|---|---|---|
| LIBERO-Spatial | libero_spatial | 10 | Các tác vụ đòi hỏi suy luận về các quan hệ không gian |
| LIBERO-Object | libero_object | 10 | Các tác vụ tập trung vào việc thao tác với các đối tượng khác nhau |
| LIBERO-Goal | libero_goal | 10 | Các tác vụ có điều kiện theo mục tiêu với các mục tiêu thay đổi |
| LIBERO-90 | libero_90 | 90 | Các tác vụ tầm ngắn từ bộ sưu tập LIBERO-100 |
| LIBERO-Long | libero_10 | 10 | Các tác vụ dài hạn từ bộ sưu tập LIBERO-100 |
Cài đặt
Sau khi làm theo các hướng dẫn cài đặt LeRobot:
pip install -e ".[libero]"LIBERO requires Linux (`sys_platform == 'linux'`). LeRobot uses MuJoCo for simulation — set the rendering backend before training or evaluation:export MUJOCO_GL=egl # for headless servers (HPC, cloud)
Đánh giá
Đánh giá cục bộ mặc định
Đánh giá trên bốn bộ tiêu chuẩn (10 tập cho mỗi tác vụ):
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=libero \
  --env.task=libero_spatial,libero_object,libero_goal,libero_10 \
  --eval.batch_size=1 \
  --eval.n_episodes=10 \
  --env.max_parallel_tasks=1
Đánh giá bộ duy nhất
Đánh giá trên một bộ LIBERO:
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=libero \
  --env.task=libero_object \
  --eval.batch_size=2 \
--eval.n_episodes=3--env.taskchọn bộ bài tập (libero_object,libero_spatial, v.v.).--env.task_idsgiới hạn ở các chỉ mục tác vụ cụ thể ([0],[1,2,3], v.v.). Bỏ qua để chạy tất cả các tác vụ trong bộ.--eval.batch_sizekiểm soát số lượng môi trường chạy song song.--eval.n_episodesthiết lập số lượng episode cần chạy cho mỗi task.
Đánh giá đa bộ
Đánh giá hiệu năng của một chính sách trên nhiều bộ bài kiểm tra cùng lúc bằng cách truyền vào một danh sách phân tách bằng dấu phẩy:
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=libero \
  --env.task=libero_object,libero_spatial \
  --eval.batch_size=1 \
  --eval.n_episodes=2
Chế độ điều khiển
LIBERO hỗ trợ hai chế độ điều khiển — relative (mặc định) và absolute. Các checkpoint VLA khác nhau được huấn luyện với các tham số hóa hành động khác nhau, vì vậy hãy đảm bảo chế độ khớp với chính sách của bạn:
--env.control_mode=relative # or "absolute"Đặt lại hiệu suất
Mặc định, LeRobot giữ nguyên hành vi hard-reset của LIBERO. Khi đã bật các trạng thái ban đầu cố định, bạn có thể chọn dùng soft reset để bỏ qua việc xây dựng lại mô hình mô phỏng và trình render ở mỗi episode:
--env.init_states=true --env.hard_reset=falseSoft resets nhanh hơn nhưng không giống hệt bit với hard resets sau các bước ổn định của môi trường, do đó quan sát từ camera và kết quả chính sách có thể khác nhau đôi chút. Hãy dùng hard resets khi tái tạo kết quả benchmark.
Đầu vào và đầu ra của Policy
Quan sát:
observation.state— 8 chiều đặc trưng cảm nhận bản thân (vị trí eef, hướng axis-angle, qpos của kẹp)observation.images.image— góc nhìn từ camera chính (agentview_image), HWC uint8observation.images.image2— góc nhìn camera cổ tay (robot0_eye_in_hand_image), HWC uint8
LeRobot enforces the `.images.*` prefix for visual features. Ensure your policy config `input_features` use the same naming keys, and that your dataset metadata keys follow this convention. If your data contains different keys, you must rename the observations to match what the policy expects, since naming keys are encoded inside the normalization statistics layer.
Thao tác:
- Điều khiển liên tục trong
Box(-1, 1, shape=(7,))— delta của đầu cuối 6D + kẹp 1D
Các tập đánh giá được khuyến nghị
Để benchmark có thể tái lập, hãy sử dụng 10 episodes cho mỗi task trên cả bốn bộ tiêu chuẩn (Spatial, Object, Goal, Long). Điều này cho tổng cộng 400 episodes và khớp với giao thức được sử dụng cho các kết quả đã công bố. Tỷ lệ thành công có thể dao động vài phần trăm giữa các seed đánh giá, vì vậy chúng tôi khuyến nghị lấy trung bình trên 3 seeds.
lerobot-eval báo cáo khoảng Wilson 95% (pc_success_ci95) bên cạnh mỗi tỷ lệ thành công. Với 10 episode, một tác vụ đạt 9/10 có khoảng dao động xấp xỉ từ 60% đến 98%, và tổng bộ 400 episode đạt 80% có khoảng xấp xỉ từ 76% đến 84%. Hai policy có khoảng dao động chồng lấn trên một tác vụ chưa được chứng minh là khác biệt trên tác vụ đó trong lần chạy đó. Khoảng dao động bao phủ các episode được chọn; nó không bao phủ training seed của policy, thứ cần nhiều hơn một lần chạy training để đo lường.
To compare two policies on the same episodes, use the same `--seed`, keep `--env.init_states=true`, and run each task in a single batch (`--eval.batch_size` equal to episodes per task).
Huấn luyện
Bộ dữ liệu
Hai bộ dữ liệu LIBERO đã được tiền xử lý tương thích hoàn toàn với LeRobot. Chúng chứa cùng các bản demo với cùng schema và khác nhau ở cách lưu trữ các khung hình camera:
| lerobot/libero | HuggingFaceVLA/libero | |
|---|---|---|
| episodes / frames / tasks | 1,693 / 273,465 / 40 | 1,693 / 273,465 / 40 |
| cameras | 2× 256×256×3 | 2× 256×256×3 |
| chiều trạng thái / hành động | 8 / 7 | 8 / 7 |
| định dạng tập dữ liệu | v3.0 | v3.0 |
| mã hóa camera | Video MP4 | PNG trong parquet |
| kích thước tải xuống | 1,9 GB | 69,9 GB |
| phụ thuộc bổ sung | backend video (torchcodec hoặc pyav) | none |
Chúng tôi khuyến nghị lerobot/libero: khối lượng tải xuống nhỏ hơn 37 lần với tốc độ tải tương đương (~330 mẫu/giây cho mỗi worker). Việc mã hóa lại video có thể gây mất mát nhẹ; hãy sử dụng biến thể dựa trên ảnh nếu bạn không thể cài đặt backend giải mã video.
Để tham khảo, bộ dữ liệu gốc do Physical Intelligence công bố:
Pin `--dataset.revision=` when reporting results — Hub datasets can be re-uploaded, and success rates are only comparable against the same data revision.
Lệnh huấn luyện mẫu
Huấn luyện SmolVLA trên bộ dữ liệu được khuyến nghị:
lerobot-train \
  --policy.type=smolvla \
  --policy.load_vlm_weights=true \
  --policy.push_to_hub=false \
  --dataset.repo_id=lerobot/libero \
  --dataset.video_backend=torchcodec \
  --output_dir=./outputs/libero_smolvla \
  --steps=100000 \
  --batch_size=64
Để chia sẻ kết quả trên Hub, hãy thay --policy.push_to_hub=false bằng --policy.repo_id=${HF_USER}/libero-smolvla. Đánh giá các checkpoint đã lưu bằng lerobot-eval như được minh họa trong phần Đánh giá.
Tái tạo các kết quả đã công bố
Chúng tôi tái hiện kết quả của Pi0.5 trên benchmark LIBERO. Chúng tôi sử dụng mô hình cơ sở LIBERO của Physical Intelligence (pi05_libero) và tinh chỉnh thêm 6k bước ở bfloat16, với batch size là 256 trên 8 GPU H100 bằng cách sử dụng dataset LIBERO của HuggingFace.
Mô hình đã tinh chỉnh: lerobot/pi05_libero_finetuned
Lệnh đánh giá
lerobot-eval \
  --output_dir=./eval_logs/ \
  --env.type=libero \
  --env.task=libero_spatial,libero_object,libero_goal,libero_10 \
  --eval.batch_size=1 \
  --eval.n_episodes=10 \
  --policy.path=lerobot/pi05_libero_finetuned \
  --policy.n_action_steps=10 \
  --env.max_parallel_tasks=1
Chúng tôi đặt n_action_steps=10, khớp với cài đặt gốc của OpenPI.
Kết quả
| Mô hình | LIBERO Spatial | LIBERO Object | Mục tiêu LIBERO | LIBERO 10 | Trung bình |
|---|---|---|---|---|---|
| Pi0.5 (LeRobot) | 97.0 | 99.0 | 98.0 | 96.0 | 97.5 |
Những kết quả này nhất quán với kết quả ban đầu do Physical Intelligence công bố:
| Mô hình | LIBERO Spatial | LIBERO Object | Mục tiêu LIBERO | LIBERO 10 | Trung bình |
|---|---|---|---|---|---|
| Pi0.5 (OpenPI) | 98.8 | 98.2 | 98.0 | 92.4 | 96.85 |