# ViTMAE
[ViTMAE](https://huggingface.co/papers/2111.06377) est un modèle de vision auto-supervisé pré-entraîné en masquant de larges portions d'une image (~75 %). Un encodeur traite les patches d'image visibles et un décodeur reconstruit les pixels manquants à partir des patches encodés et des jetons de masque. Après le pré-entraînement, l'encodeur peut être réutilisé pour des tâches en aval telles que la classification d'images ou la détection d'objets — il surpasse souvent les modèles entraînés par apprentissage supervisé.
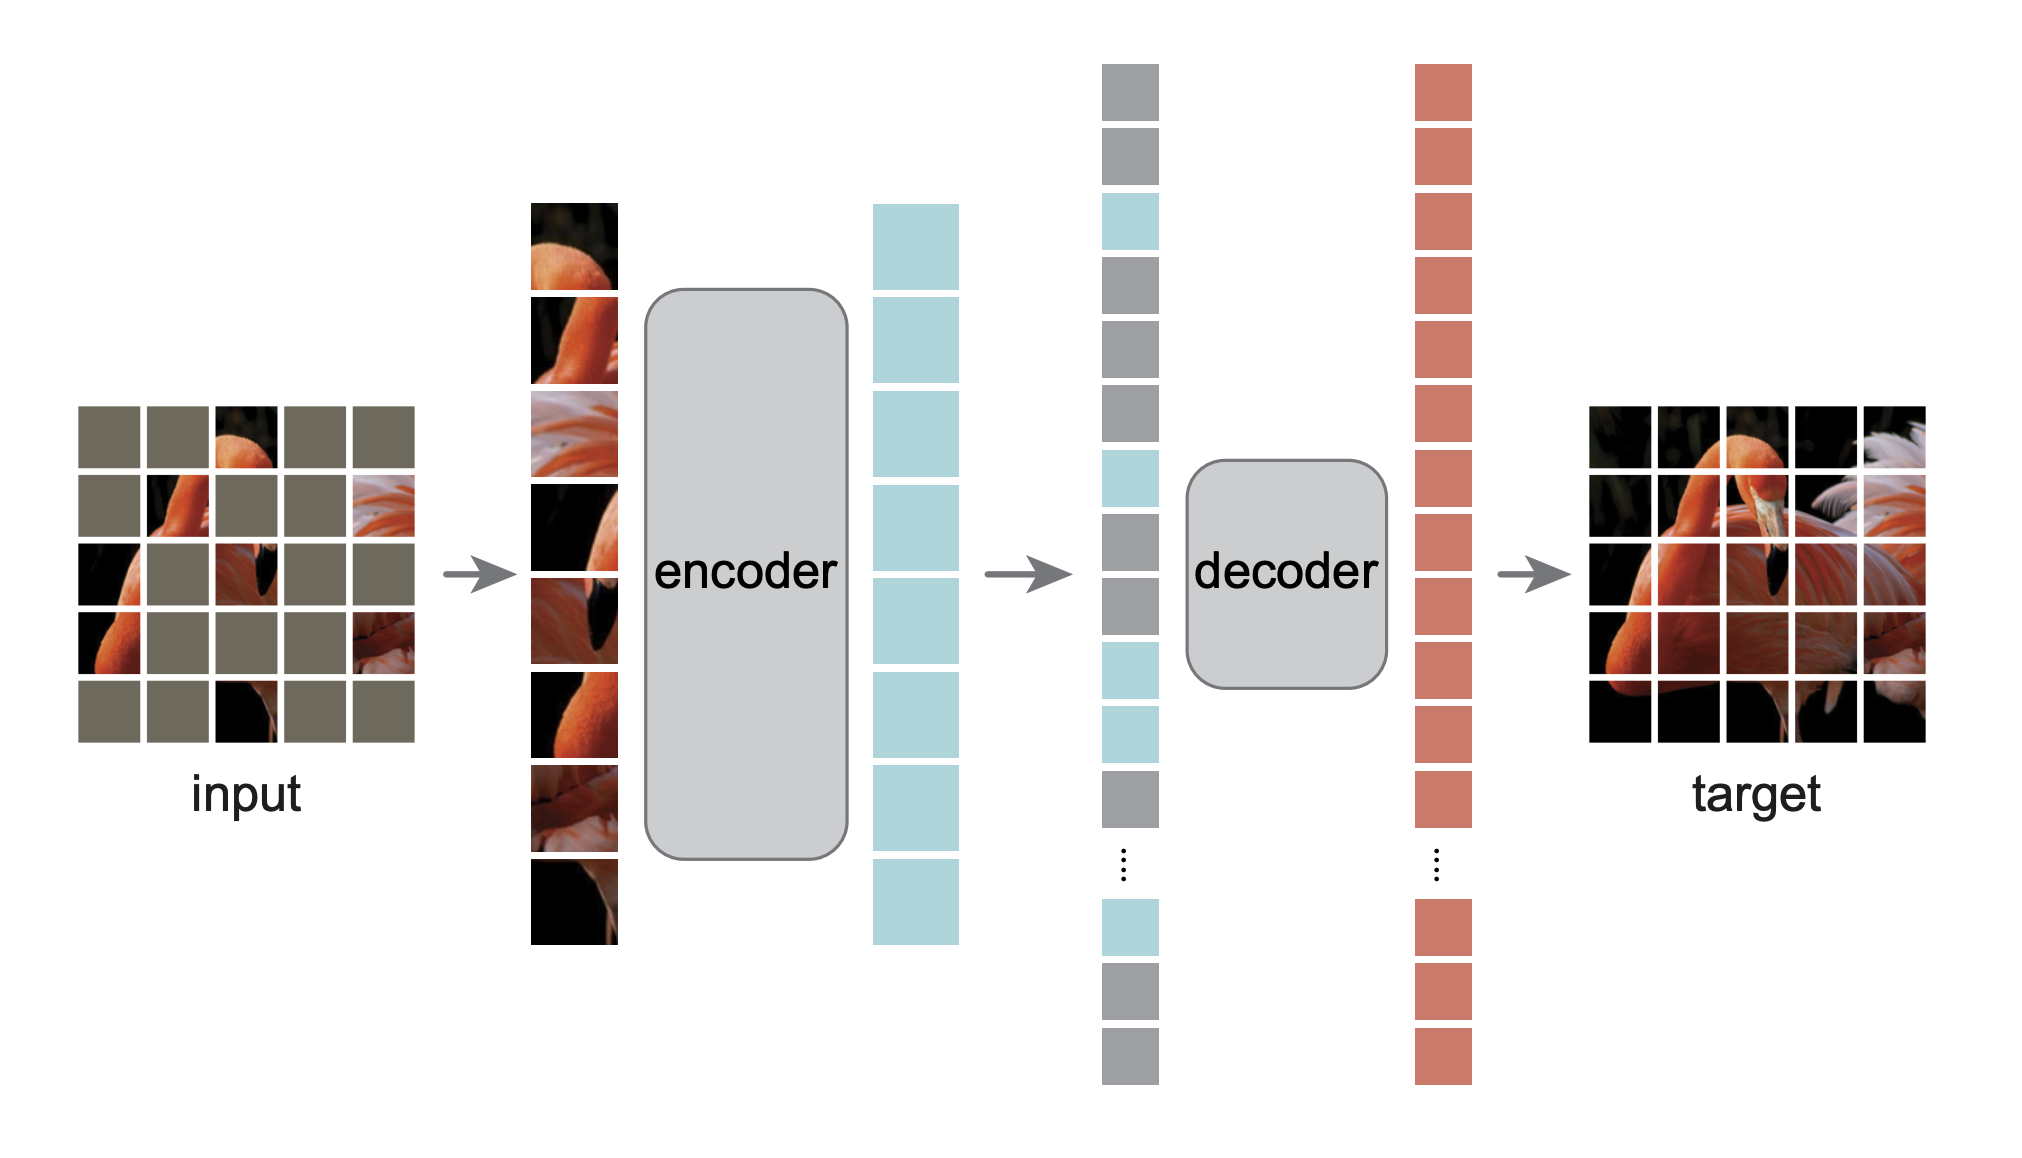 Vous pouvez trouver tous les points de contrôle originaux de ViTMAE sous l’organisation [AI at Meta](https://huggingface.co/facebook?search_models=vit-mae).
> [!TIP]
> Cliquez sur les modèles ViTMAE dans la barre latérale droite pour plus d’exemples sur l’application de ViTMAE à des tâches de vision.
L'exemple ci-dessous montre comment reconstruire les pixels manquants à l'aide de la classe [ViTMAEForPreTraining](/docs/transformers/main/fr/model_doc/vit_mae#transformers.ViTMAEForPreTraining).
```python
import requests
import torch
from PIL import Image
from transformers import ViTImageProcessor, ViTMAEForPreTraining
url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"
image = Image.open(requests.get(url, stream=True).raw)
processor = ViTImageProcessor.from_pretrained("facebook/vit-mae-base")
inputs = processor(image, return_tensors="pt").to(model.device)
inputs = {k: v.to(model.device) for k, v in inputs.items()}
model = ViTMAEForPreTraining.from_pretrained("facebook/vit-mae-base", attn_implementation="sdpa", device_map="auto")
with torch.no_grad():
outputs = model(**inputs)
reconstruction = outputs.logits
```
## Notes
- ViTMAE est généralement utilisé en deux étapes. D'abord, un pré-entraînement auto-supervisé avec [ViTMAEForPreTraining](/docs/transformers/main/fr/model_doc/vit_mae#transformers.ViTMAEForPreTraining), puis l'abandon du décodeur et l'ajustement fin de l'encodeur. Après l'ajustement fin, les poids peuvent être intégrés dans un modèle tel que [ViTForImageClassification](/docs/transformers/main/fr/model_doc/vit#transformers.ViTForImageClassification).
- Utilisez [ViTImageProcessor](/docs/transformers/main/fr/model_doc/vit#transformers.ViTImageProcessor) pour la préparation des entrées.
## Ressources
- Reportez-vous à ce [notebook](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/ViTMAE/ViT_MAE_visualization_demo.ipynb) pour apprendre à visualiser les pixels reconstruits à partir de [ViTMAEForPreTraining](/docs/transformers/main/fr/model_doc/vit_mae#transformers.ViTMAEForPreTraining).
## ViTMAEConfig[[transformers.ViTMAEConfig]]
#### transformers.ViTMAEConfig[[transformers.ViTMAEConfig]]
```python
transformers.ViTMAEConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.0, attention_probs_dropout_prob: float | int = 0.0, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 16, num_channels: int = 3, qkv_bias: bool = True, decoder_num_attention_heads: int = 16, decoder_hidden_size: int = 512, decoder_num_hidden_layers: int = 8, decoder_intermediate_size: int = 2048, mask_ratio: float = 0.75, norm_pix_loss: bool = False)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vit_mae/configuration_vit_mae.py#L24)
**Paramètres :**
hidden_size (`int`, *facultatif*, par défaut `768`) : Dimension des représentations cachées.
num_hidden_layers (`int`, *facultatif*, par défaut `12`) : Nombre de couches cachées dans le décodeur Transformer.
num_attention_heads (`int`, *facultatif*, valeur par défaut `12`) : Nombre de têtes d'attention pour chaque couche d'attention du décodeur Transformer.
intermediate_size (`int`, *facultatif*, par défaut `3072`) : Dimension des représentations MLP.
hidden_act (`str`, *facultatif*, par défaut `gelu`) : La fonction d'activation non linéaire (fonction ou chaîne de caractères) dans le décodeur. Par exemple, `"gelu"`, `"relu"`, `"silu"`, etc.
hidden_dropout_prob (`Union[float, int]`, *facultatif*, valeur par défaut `0.0`) : La probabilité de dropout pour toutes les couches entièrement connectées des embeddings, de l'encodeur et du pooler.
attention_probs_dropout_prob (`Union[float, int]`, *facultatif*, valeur par défaut `0.0`) : Le taux de dropout appliqué aux probabilités d'attention.
initializer_range (`float`, *facultatif*, valeur par défaut `0.02`) : L'écart-type de la truncated_normal_initializer utilisé pour l'initialisation de toutes les matrices de poids.
layer_norm_eps (`float`, *facultatif*, par défaut `1e-12`) : L'épsilon utilisé par les couches de normalisation par couche.
image_size (`Union[int, list[int], tuple[int, int]]`, *facultatif*, valeur par défaut `224`) : La taille (résolution) de chaque image.
patch_size (`Union[int, list[int], tuple[int, int]]`, *facultatif*, valeur par défaut `16`) : La taille (résolution) de chaque patch.
num_channels (`int`, *facultatif*, par défaut `3`) : Le nombre de canaux d'entrée.
qkv_bias (`bool`, *facultatif*, par défaut `True`) : Indique s'il faut ajouter un biais aux requêtes, clés et valeurs.
decoder_num_attention_heads (`int`, *facultatif*, valeur par défaut `16`) : Nombre de têtes d'attention pour chaque couche d'attention du décodeur Transformer.
decoder_hidden_size (`int`, *facultatif*, par défaut `512`) : Dimension des représentations cachées.
decoder_num_hidden_layers (`int`, *facultatif*, valeur par défaut : 8) : Nombre de couches cachées dans le décodeur.
decoder_intermediate_size (`int`, *facultatif*, valeur par défaut `2048`) : Dimension des représentations MLP.
mask_ratio (`float`, *facultatif*, valeur par défaut 0,75) : Le ratio du nombre de jetons masqués dans la séquence d'entrée.
norm_pix_loss (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut ou non entraîner avec des pixels normalisés (voir le tableau 3 de l'article). L'utilisation de pixels normalisés a amélioré la qualité de la représentation dans les expériences des auteurs.
Ceci est la classe de configuration destinée à stocker la configuration d'un ViTMAEModel. Elle est utilisée pour instancier un modèle Vit Mae en fonction des arguments spécifiés, en définissant l'architecture du modèle. L'instanciation d'une configuration avec les valeurs par défaut produira une configuration similaire à celle de [facebook/vit-mae-base](https://huggingface.co/facebook/vit-mae-base)
Les objets de configuration héritent de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) et peuvent être utilisés pour contrôler les sorties du modèle. Consultez la documentation de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) pour plus d’informations.
Exemple :
```python
>>> from transformers import ViTMAEConfig, ViTMAEModel
>>> # Initializing a ViT MAE vit-mae-base style configuration
>>> configuration = ViTMAEConfig()
>>> # Initializing a model (with random weights) from the vit-mae-base style configuration
>>> model = ViTMAEModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## ViTMAEModel[[transformers.ViTMAEModel]]
#### transformers.ViTMAEModel[[transformers.ViTMAEModel]]
```python
transformers.ViTMAEModel(config: ViTMAEConfig)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vit_mae/modeling_vit_mae.py#L614)
**Paramètres :**
config ([ViTMAEConfig](/docs/transformers/main/fr/model_doc/vit_mae#transformers.ViTMAEConfig)) : Configuration du modèle.
Le modèle Vit Mae brut, qui produit des états cachés bruts sans aucune tête spécifique au sommet.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.ViTMAEModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, noise: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool | None = None, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vit_mae/modeling_vit_mae.py#L628)
**Paramètres :**
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`, *facultatif*) : Les tenseurs correspondant aux images d'entrée. Les valeurs de pixels peuvent être obtenues à l'aide de [ViTImageProcessor](/docs/transformers/main/fr/model_doc/vit#transformers.ViTImageProcessor). Voir [ViTImageProcessor.__call__()](/docs/transformers/main/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails (`processor_class` utilise [ViTImageProcessor](/docs/transformers/main/fr/model_doc/vit#transformers.ViTImageProcessor) pour le traitement des images).
noise (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Utilisé principalement à des fins de test pour contrôler l'aléatoire et maintenir la reproductibilité
interpolate_pos_encoding (`bool`, *facultatif*, par défaut `False`) : Indique s'il faut interpoler les encodages de position pré-entraînés. Cette option est principalement utilisée pour exploiter le modèle sur des images de résolution plus élevée.
attention_mask (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans `[0, 1]` : - 1 pour les jetons qui ne sont **pas masqués**, - 0 pour les jetons qui sont **masqués**. [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
**Retourne :** `ViTMAEModelOutput` ou `tuple(torch.Tensor)`
Un `ViTMAEModelOutput` ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([ViTMAEConfig](/docs/transformers/main/fr/model_doc/vit_mae#transformers.ViTMAEConfig)) et les entrées.
La méthode forward du modèle [ViTMAEModel](/docs/transformers/main/fr/model_doc/vit_mae#transformers.ViTMAEModel) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **last_hidden_state** (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`, *facultatif*) -- Séquence d'états cachés à la sortie de la dernière couche du modèle.
- **mask** (`torch.Tensor` de forme `(batch_size, sequence_length)`) -- Tenseur indiquant quels patches sont masqués (1) et lesquels ne le sont pas (0).
- **ids_restore** (`torch.LongTensor` de forme `(batch_size, sequence_length)`) -- Tenseur contenant l'index d'origine des patches masqués (mélangés).
- **hidden_states** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d'embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
Exemples :
```python
>>> from transformers import AutoImageProcessor, ViTMAEModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/vit-mae-base")
>>> model = ViTMAEModel.from_pretrained("facebook/vit-mae-base")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_states = outputs.last_hidden_state
```
## ViTMAEForPreTraining[[transformers.ViTMAEForPreTraining]]
#### transformers.ViTMAEForPreTraining[[transformers.ViTMAEForPreTraining]]
```python
transformers.ViTMAEForPreTraining(config: ViTMAEConfig)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vit_mae/modeling_vit_mae.py#L691)
**Paramètres :**
config ([ViTMAEConfig](/docs/transformers/main/fr/model_doc/vit_mae#transformers.ViTMAEConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L'initialisation à partir d'un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Le modèle ViTMAE, un transformer doté d'un décodeur en tête pour la pré-entraînement auto-supervisé.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.ViTMAEForPreTraining.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, noise: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool | None = None, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vit_mae/modeling_vit_mae.py#L790)
**Paramètres :**
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`, *facultatif*) : Les tenseurs correspondant aux images d'entrée. Les valeurs de pixels peuvent être obtenues à l'aide de [ViTImageProcessor](/docs/transformers/main/fr/model_doc/vit#transformers.ViTImageProcessor). Voir [ViTImageProcessor.__call__()](/docs/transformers/main/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails (`processor_class` utilise [ViTImageProcessor](/docs/transformers/main/fr/model_doc/vit#transformers.ViTImageProcessor) pour le traitement des images).
noise (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Utilisé principalement à des fins de test pour contrôler l'aléatoire et maintenir la reproductibilité
interpolate_pos_encoding (`bool`, *facultatif*, par défaut `False`) : Indique s'il faut interpoler les encodages de position pré-entraînés. Cette option est principalement utilisée pour exploiter le modèle sur des images de résolution plus élevée.
attention_mask (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans `[0, 1]` : - 1 pour les jetons qui ne sont **pas masqués**, - 0 pour les jetons qui sont **masqués**. [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
**Retourne :** `ViTMAEForPreTrainingOutput` ou `tuple(torch.Tensor)`
Un `ViTMAEForPreTrainingOutput` ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments en fonction de la configuration ([ViTMAEConfig](/docs/transformers/main/fr/model_doc/vit_mae#transformers.ViTMAEConfig)) et des entrées.
La méthode forward de [ViTMAEForPreTraining](/docs/transformers/main/fr/model_doc/vit_mae#transformers.ViTMAEForPreTraining) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **loss** (`torch.Tensor` de forme `(1,)`) -- Perte de reconstruction des pixels.
- **logits** (`torch.Tensor` de forme `(batch_size, sequence_length, patch_size ** 2 * num_channels)`) -- Logits de reconstruction des pixels.
- **mask** (`torch.Tensor` de forme `(batch_size, sequence_length)`) -- Tenseur indiquant quels patches sont masqués (1) et lesquels ne le sont pas (0).
- **ids_restore** (`torch.LongTensor` de forme `(batch_size, sequence_length)`) -- Tenseur contenant l'index d'origine des patches masqués (mélangés).
- **hidden_states** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d'embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
Exemples :
```python
>>> from transformers import AutoImageProcessor, ViTMAEForPreTraining
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read())).convert("RGB")
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/vit-mae-base")
>>> model = ViTMAEForPreTraining.from_pretrained("facebook/vit-mae-base")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> loss = outputs.loss
>>> mask = outputs.mask
>>> ids_restore = outputs.ids_restore
```